Tasador
Un informe de tasación en alrededor de un minuto, con cada precio justificado.
Para una inmobiliaria de Buenos AiresProbado con datos reales, código publicado
- pasos del agente en LangGraph, de la dirección al PDF
- 11
- nDCG@25 de la búsqueda léxica, contra 0,747 del sistema base, sobre 113 consultas
- 0,821
- de las cifras inventadas pasan el control del texto (antes, 50,5 %)
- 4,3 %
- tests de backend y E2E con Playwright, en CI
- 492 + 55
El problema
Para decidir a qué precio publicar una propiedad, el agente inmobiliario la compara a mano con avisos parecidos: los busca en los portales, los anota en una planilla y ajusta a ojo. Es trabajo calificado y repetitivo, y dos tasaciones de la misma propiedad pueden terminar en precios distintos sin que quede escrito por qué.
El propietario escucha un número de palabra, sin un documento que lo respalde. Para una inmobiliaria de Buenos Aires, ese número es el que decide si consigue la propiedad para vender.
Qué construí
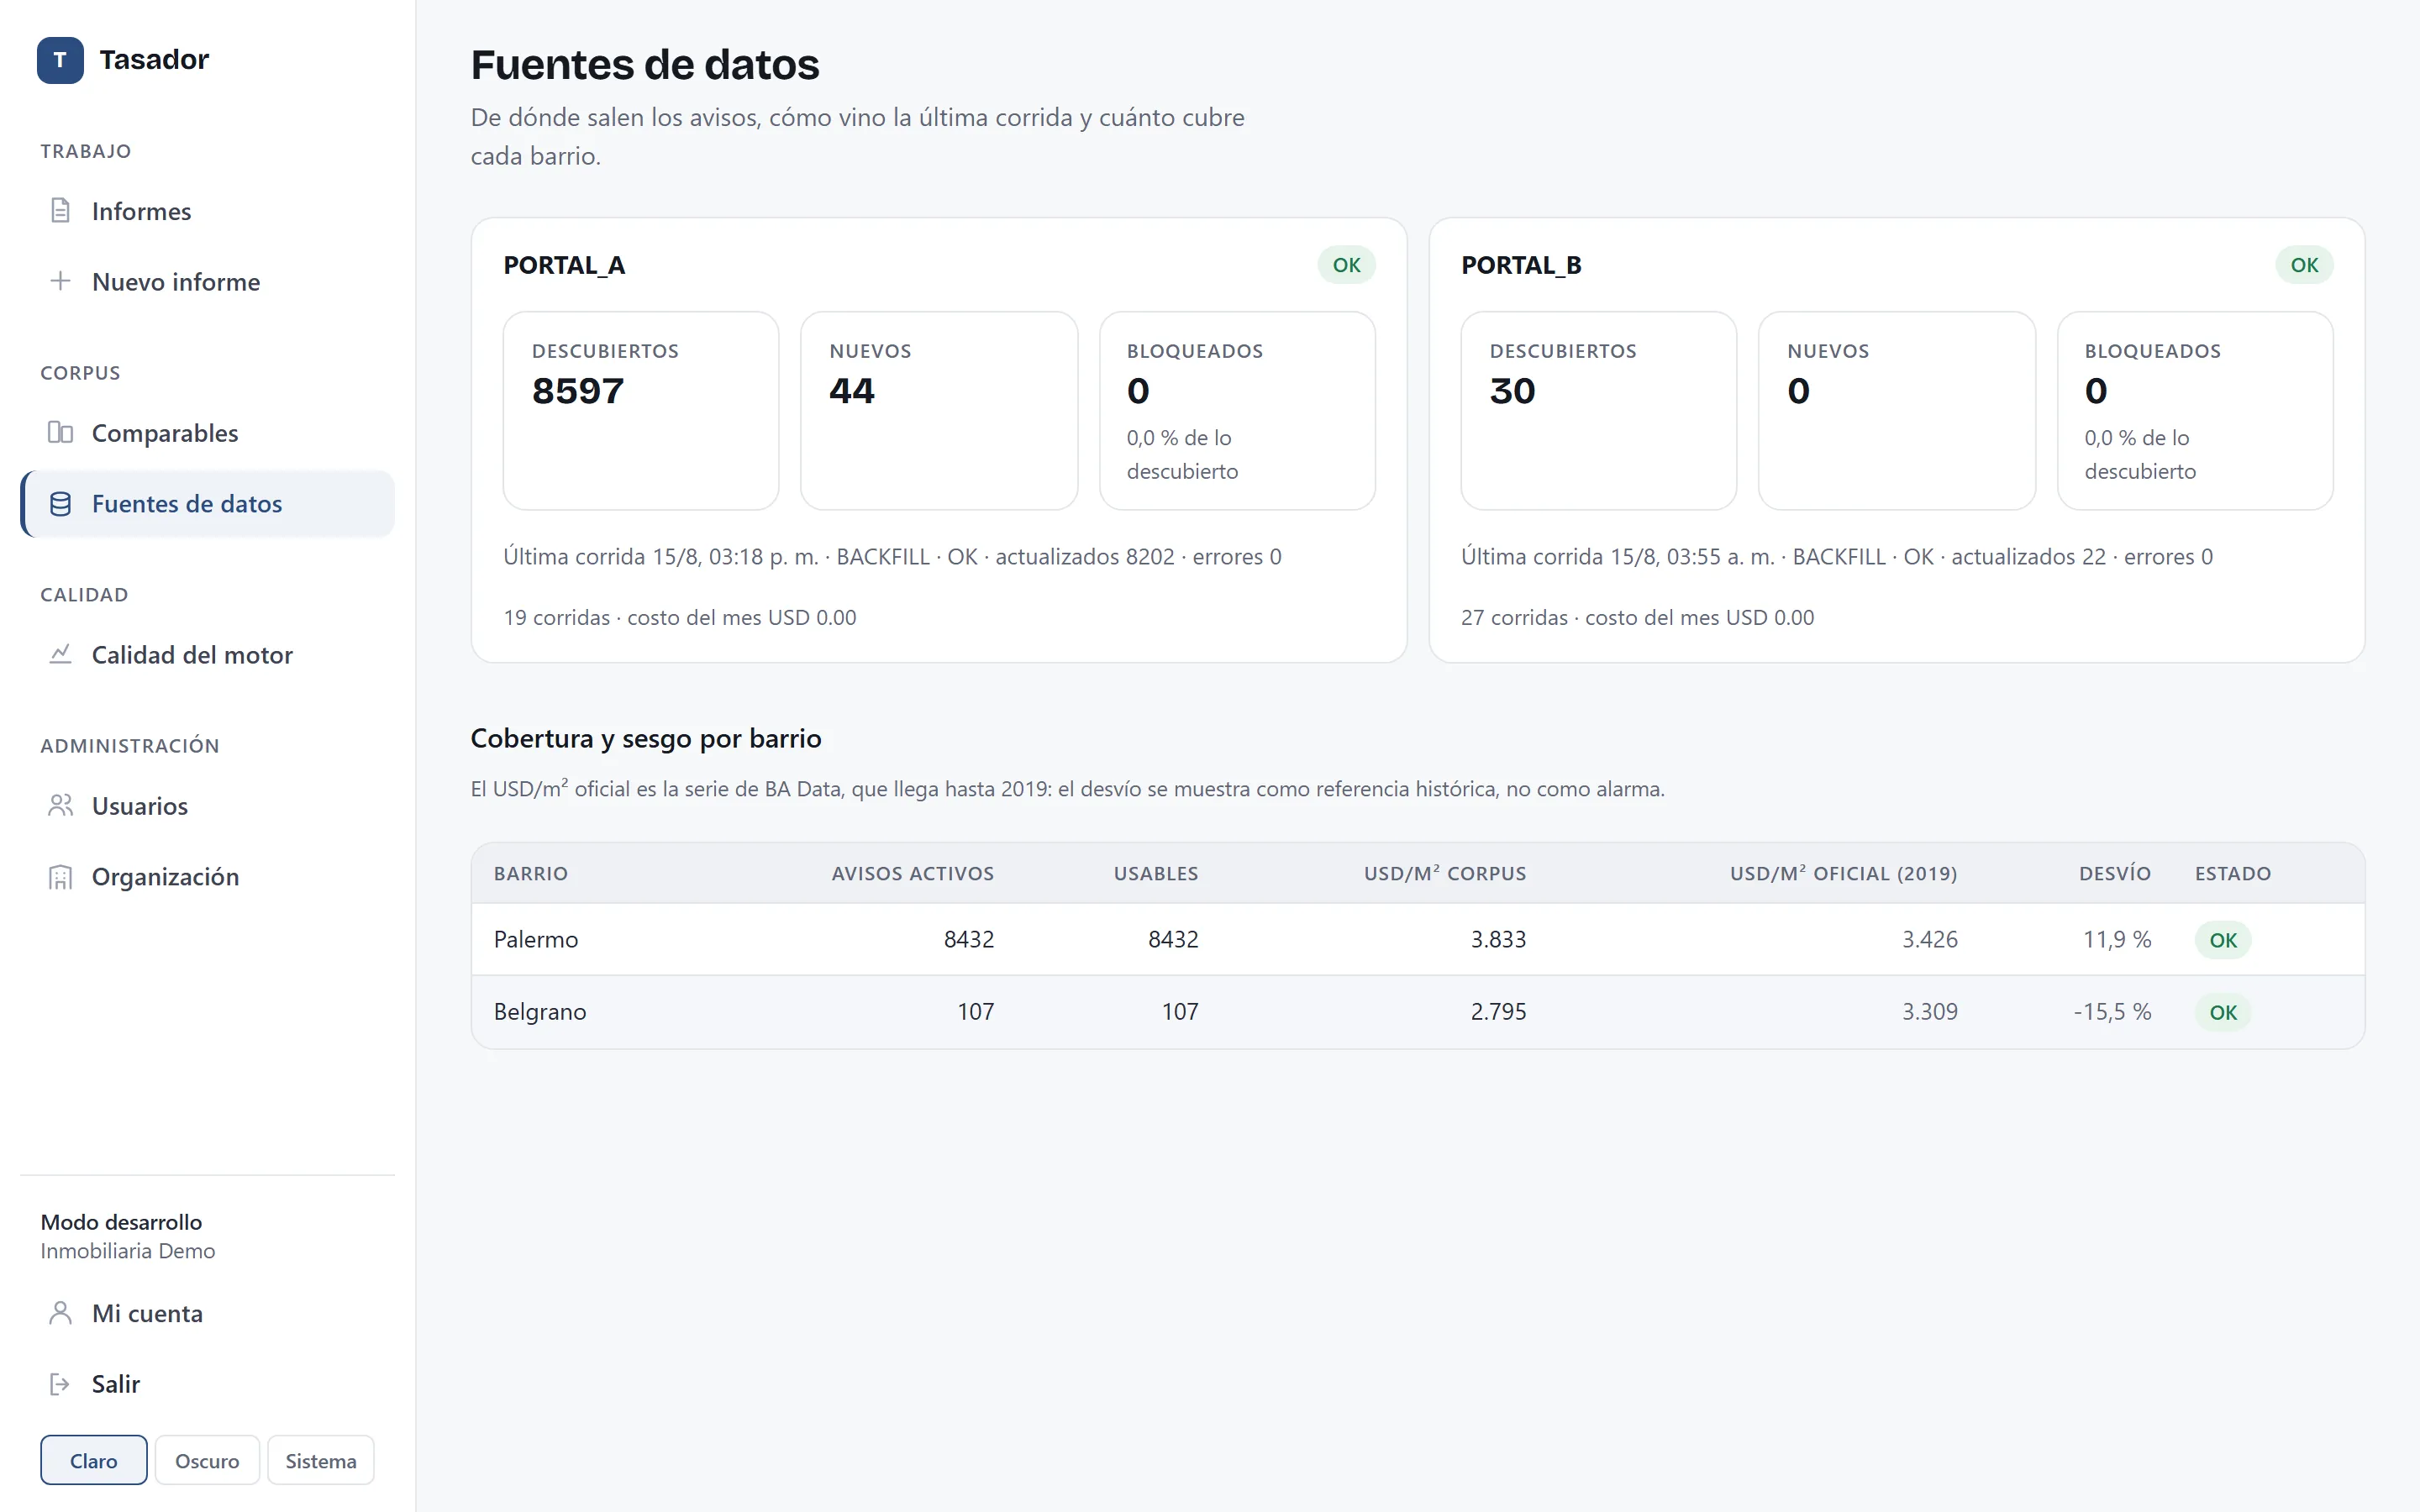
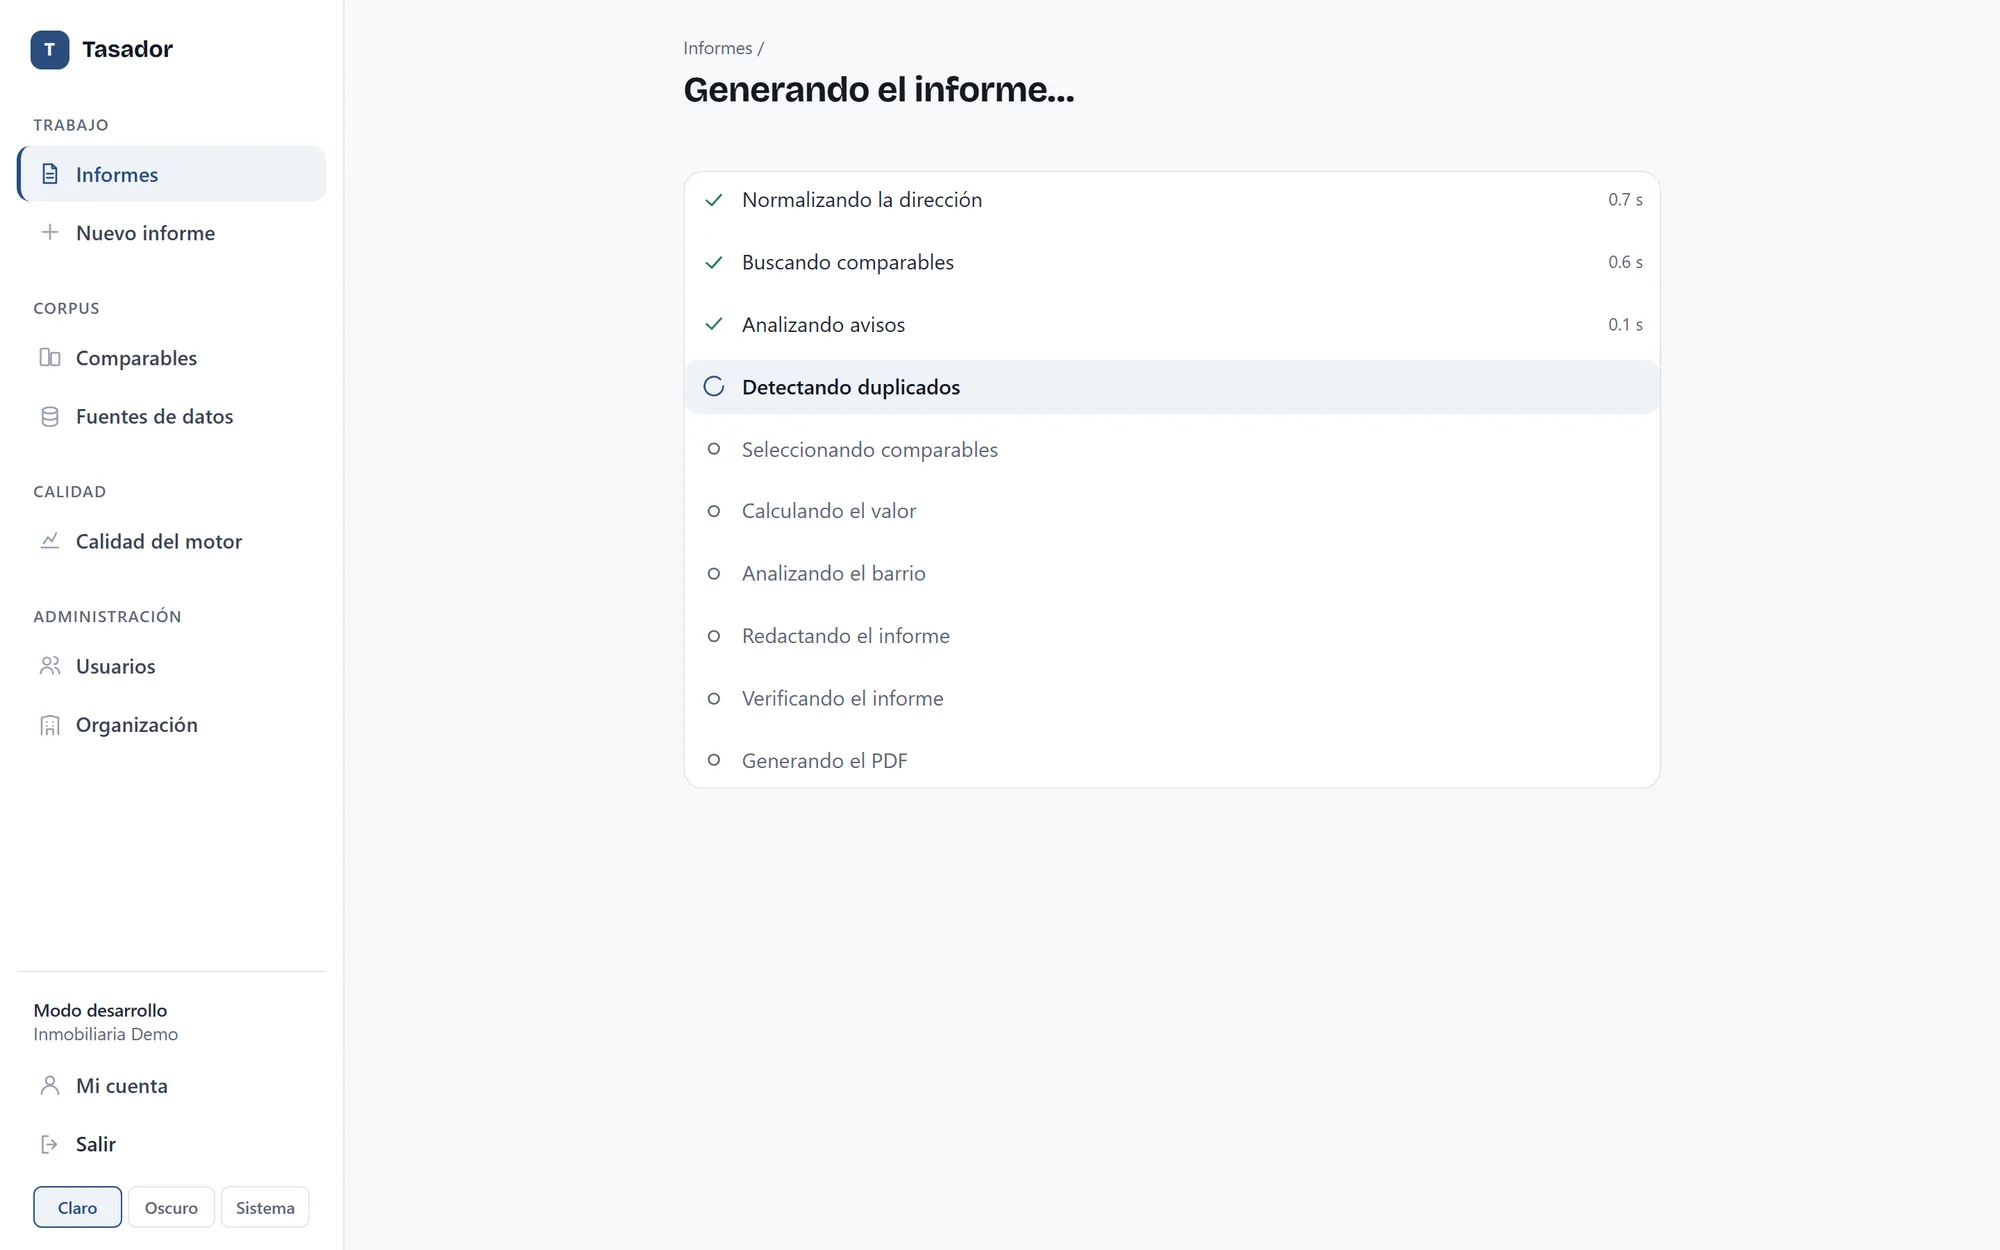
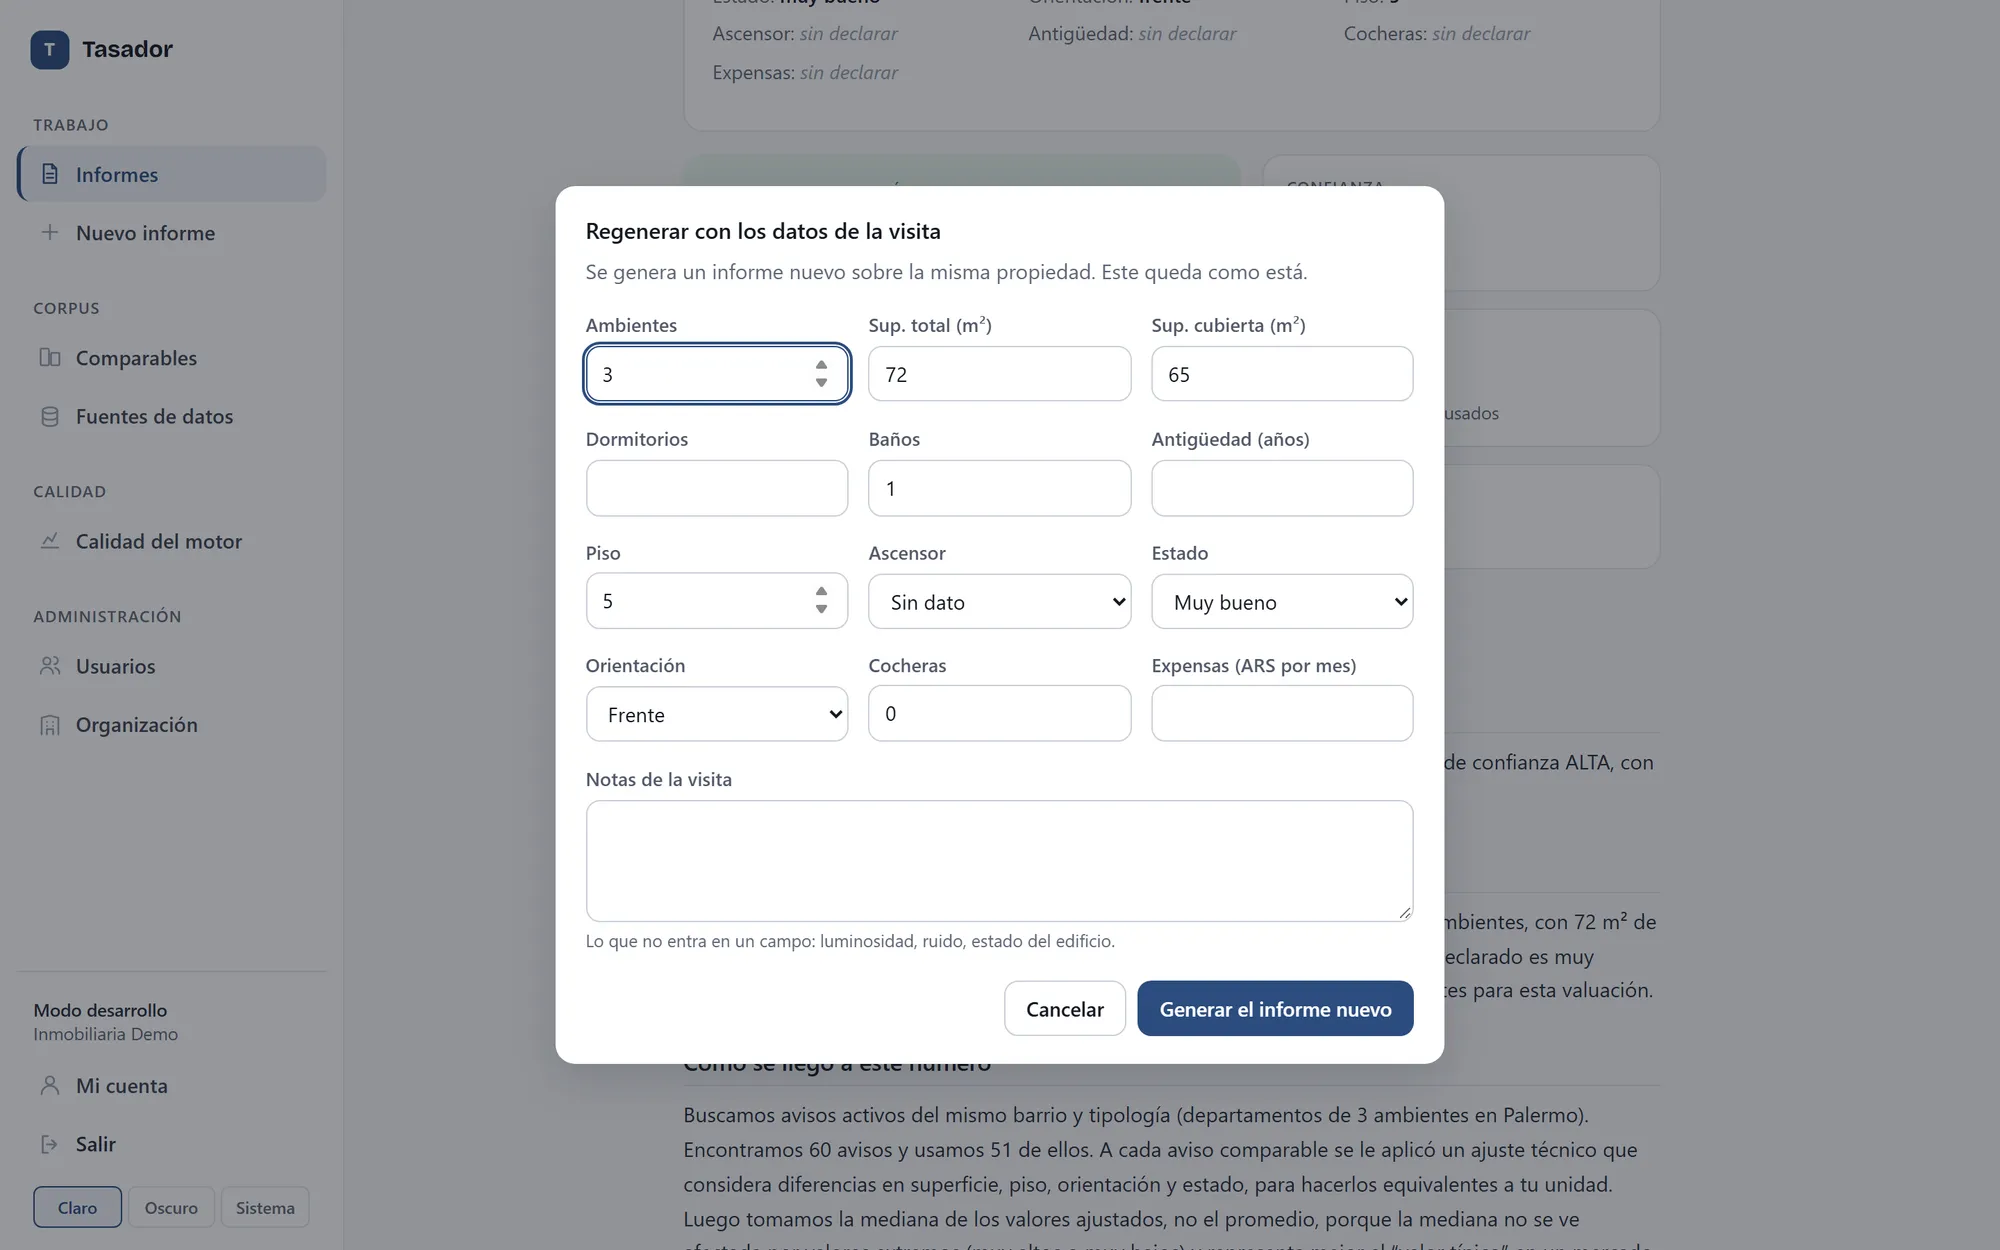
Un sistema que arma el informe de tasación en alrededor de un minuto, con los avisos comparables que justifican el precio. El agente carga la dirección y los datos que tenga, la pantalla muestra el avance paso a paso, y al final queda un informe en la web y en PDF con el precio, el rango, el nivel de confianza y la tabla de comparables: los usados y los descartados, cada uno con su motivo.
La regla que ordena todo: la IA hace lenguaje y juicio; la matemática hace los números.
- Búsqueda. Sobre un corpus de 93.544 avisos, una búsqueda léxica en español trae los candidatos vigentes del barrio que más se parecen a la propiedad.
- Lectura. Un agente de 11 pasos en LangGraph lee cada aviso, extrae lo que mueve el precio (estado, orientación, piso, ascensor, antigüedad), detecta el mismo inmueble publicado varias veces y descarta lo que no compara, como pozos o permutas.
- Verificación. Cada dato que la IA toma de un aviso viene con su cita textual, y una función sin IA comprueba que esa cita esté en el aviso original.
- Precio. Lo calcula una fórmula explícita, nunca el modelo: mediana robusta de USD/m² con coeficientes de ajuste escritos. Con menos de 5 comparables válidos, el sistema dice que no sabe.
- Redacción. Un modelo explica el resultado en lenguaje claro, y un control revisa el texto antes de entregarlo.
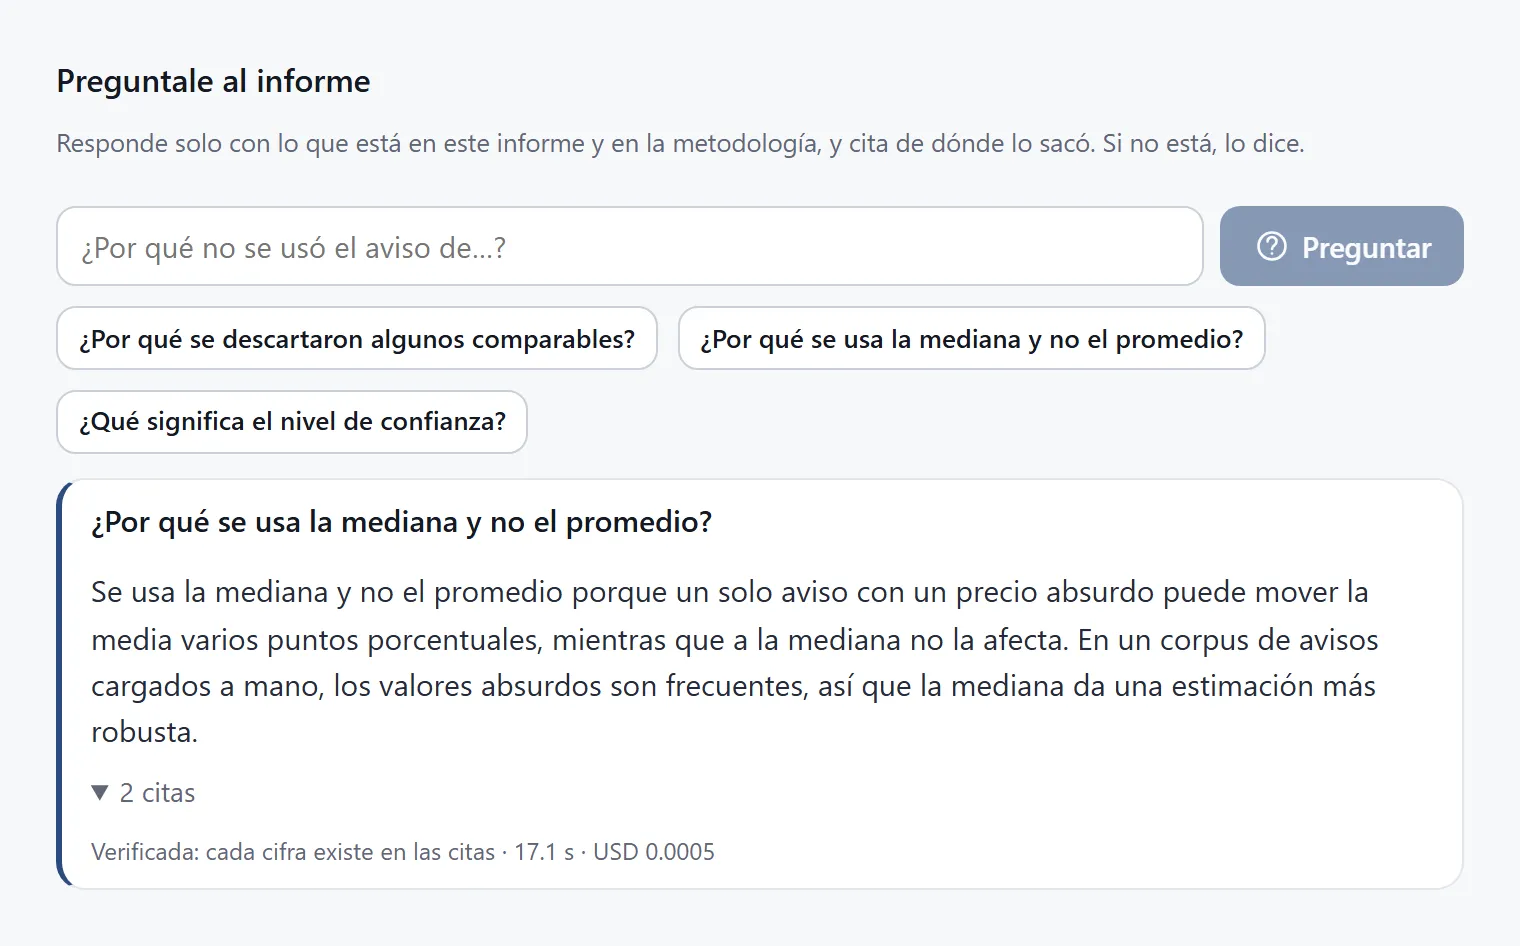
Sobre el informe terminado hay un segundo RAG, «Preguntale al informe»: el propietario pregunta por qué se descartó un aviso y recibe una respuesta con citas verificadas, o una negativa si no hay evidencia.
Alrededor hay una aplicación completa: frontend en Next.js 15 con React 19, sesión y roles, administración de usuarios, un explorador del corpus con cada aviso al lado de lo que extrajo el sistema y la salud de cada fuente de datos. Cada informe cuesta entre 2 y 5 centavos de dólar, con el costo trazado por paso.
Lo más difícil
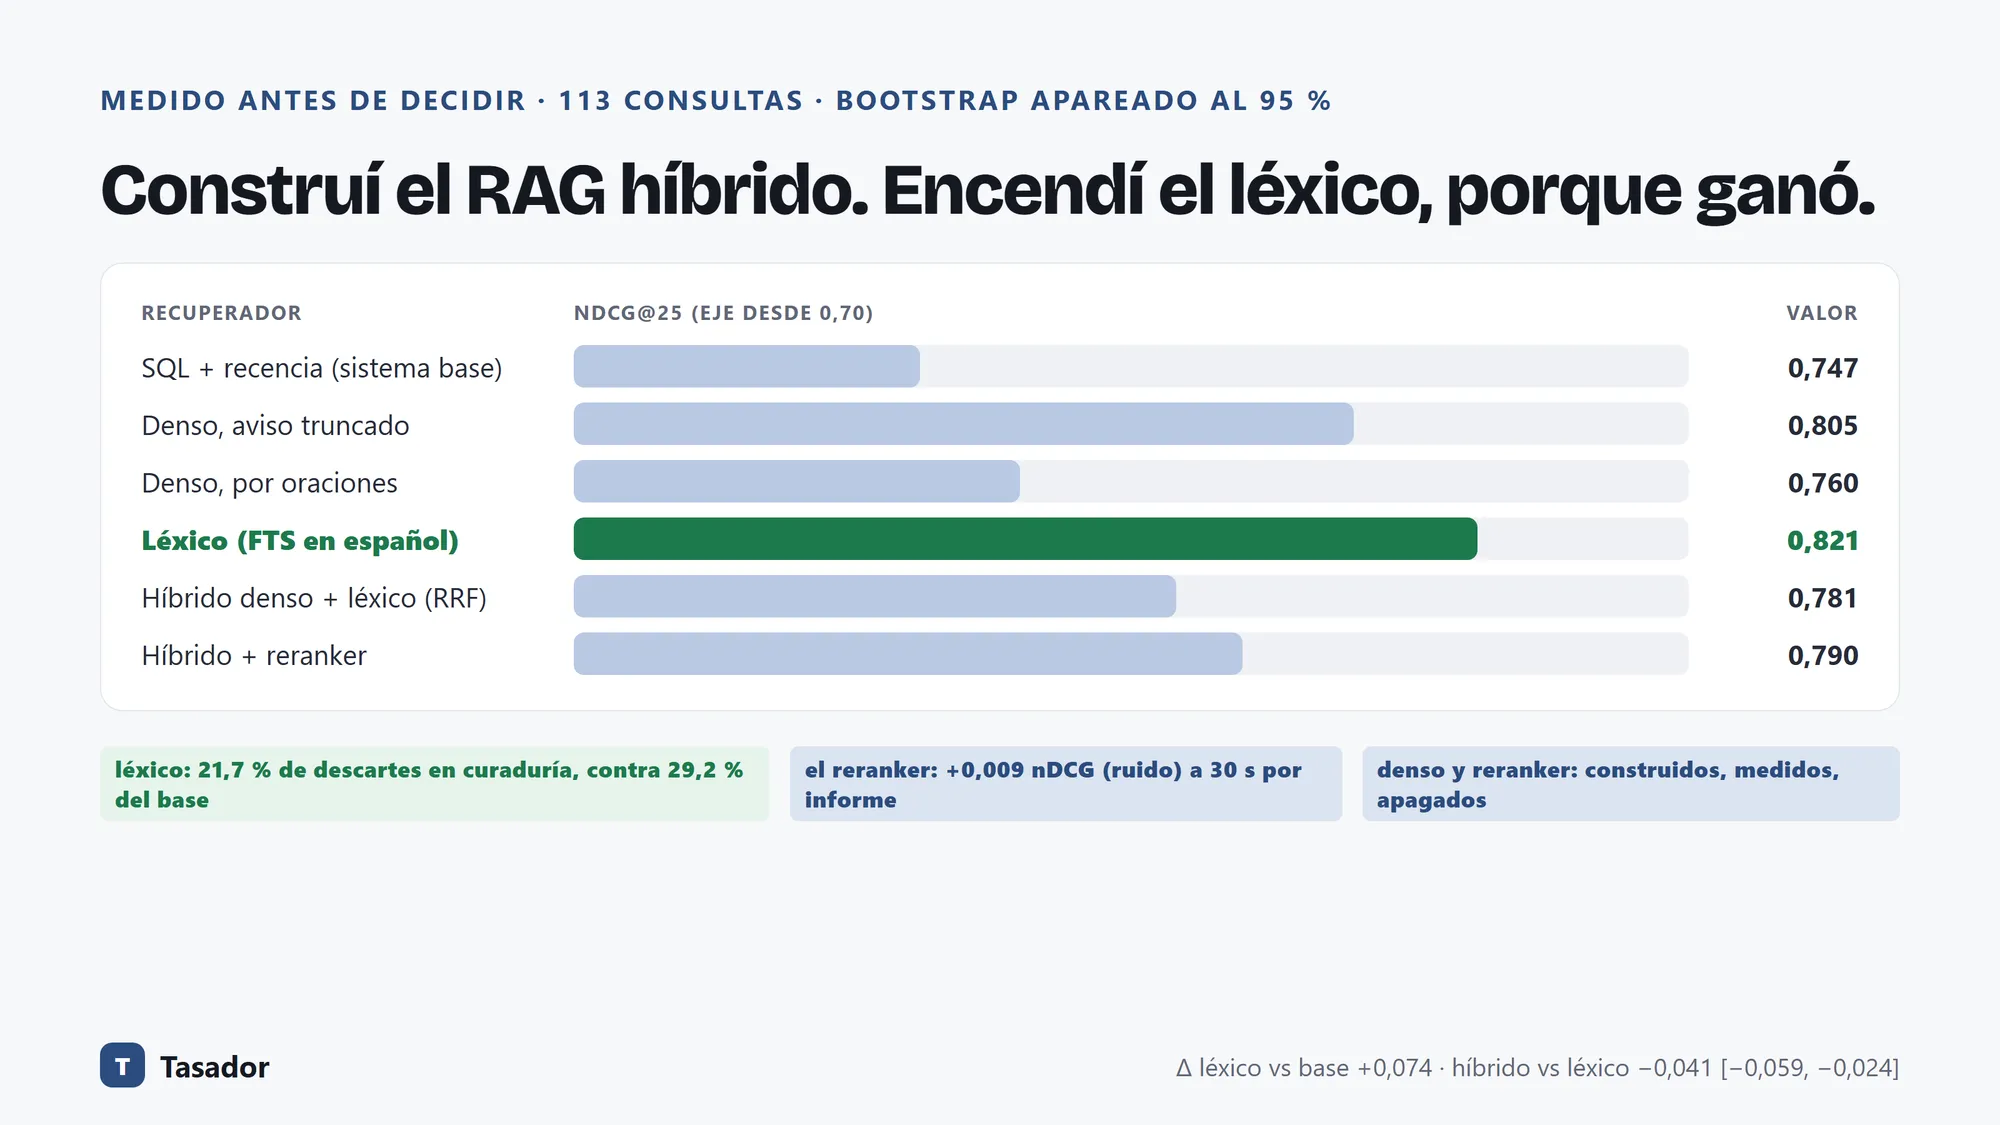
Medir el RAG antes de encenderlo, y que gane la opción más simple. Construí el RAG completo: fragmentación de avisos, embeddings locales en pgvector, búsqueda léxica, fusión por Reciprocal Rank Fusion y un reranker. Antes de medir escribí el criterio para encender cada pieza, y después armé la vara: 113 consultas, con nDCG@25, recall, MRR y bpref, e intervalos por bootstrap apareado contra el sistema base.
Ganó la búsqueda léxica sola: nDCG@25 de 0,821 contra 0,747 del sistema base, por encima de los híbridos. Es la que quedó encendida. Los embeddings densos y el reranker están construidos, medidos y apagados, a un parámetro de configuración de distancia.
Que ninguna cifra del texto se escape de los datos. El modelo redacta, y antes de entregar, un control en dos fases revisa lo que escribió. La primera fase no usa IA: extrae cada número de la prosa y lo busca en los datos del informe, y una sola cifra que no aparece rechaza el texto. La segunda es un modelo adversarial que busca afirmaciones sin respaldo. Si el texto se rechaza tres veces, el informe sale con la tabla y el rango, que vienen de la fórmula, y sin prosa.
Lo audité inyectando precios inventados en informes reales: al principio pasaba el 50,5 %; después de tres correcciones medidas, el 4,3 %.
Cómo se prueba
- 492 tests de backend con pytest, incluidos tests de arquitectura que impiden asignarle un modelo al paso que calcula el precio o ablandar el mínimo de comparables.
- 55 tests E2E con Playwright contra el stack real, sin mocks, en escritorio y en celular. Verifican decisiones de producto: que un informe sin datos suficientes no se lea como un error, que cada campo tenga su etiqueta, que el contraste cumpla AA en los dos temas.
- CI en GitHub Actions en cada cambio: lint, tipos, migraciones desde cero, aislamiento entre organizaciones, búsqueda de secretos y escaneo de las imágenes de Docker.
- Datos reales de mercado: el sistema corre sobre el corpus real de 93.544 avisos de Buenos Aires. El repositorio incluye además un corpus sintético para levantar todo el sistema con Docker Compose desde una base vacía.
Cómo funciona
- 01Pedido de tasacióndirección y datos
- 02Corpus de avisos93.544 avisos
- 02Búsqueda léxicaavisos parecidos
- 03El agente leeelige comparables
- 04Verifica cada citasin IA, en el aviso
- 05Fórmula de preciomediana de USD/m²
- 06Redacciónel modelo explica
- 07Control de cifrastoda cifra en datos
- 08Informe y PDFcon comparables
- 09Preguntalecitas verificadas
Resultados
El precio lo calcula una fórmula
Mediana robusta de USD/m² con coeficientes de ajuste escritos. Un test de arquitectura impide asignarle un modelo a ese paso.
Cada dato, con su cita
Lo que la IA extrae de un aviso viene con el fragmento textual que lo respalda, y una función sin IA comprueba que esté en el original.
Sabe decir que no sabe
Con menos de 5 comparables válidos no emite precio y muestra por qué se cayó cada candidato.
Preguntale al informe
Un segundo RAG responde con citas verificadas, o se niega en milisegundos si no hay evidencia.
2 a 5 centavos de dólar por informe
El costo queda trazado por paso y por llamada al modelo.
93.544 avisos en el corpus
Ingesta idempotente por hash, deduplicación en cascada y el mismo inmueble contado una sola vez.
Galería
Stack
- Aplicación
- Next.js 15React 19TypeScriptPython 3.12FastAPIPydantic v2
- IA y búsqueda
- LangGraphLiteLLMBúsqueda léxica en PostgreSQLpgvectorfastembedReciprocal Rank Fusion
- Datos
- PostgreSQL 16RedisSQLAlchemy 2Alembicpg_trgm
- Calidad y despliegue
- pytestPlaywrightmypyGitHub ActionsDocker Compose